# Hadoop Family
- URL: https://www.yidoo.xyz/hadoop-family
- 作者: 核动力蜗牛
- 发布时间: 2013-10-13
- 更新时间: 2013-10-13
- 分类: 技术笔记
- 标签: bigdata, hadoop
Hadoop 作为目前炙手可热的大数据计算平台,以其稳定性和良好的可扩展性深得业界喜爱。目前 Hadoop 发展迅速,已经形成了一个以 Hadoop 为中心的生态圈。
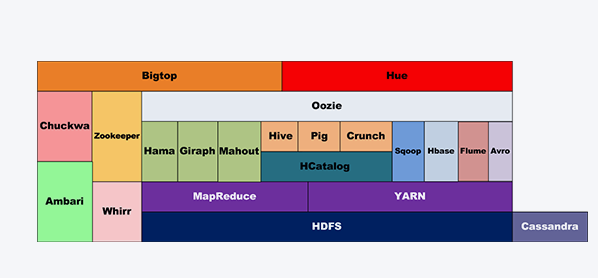
[Apache Hadoop](http://hadoop.apache.org/): 是 Apache 开源组织的一个分布式计算开源框架,提供了一个分布式文件系统子项目(HDFS)和支持 MapReduce 分布式计算的软件架构。
[Apache Hive](http://hive.apache.org/): 是基于 Hadoop 的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,通过类 SQL 语句快速实现简单的 MapReduce 统计,不必开发专门的 MapReduce 应用,十分适合数据仓库的统计分析。
[Apache Pig](http://pig.apache.org/): 是一个基于 Hadoop 的大规模数据分析工具,它提供的 SQL-LIKE 语言叫 Pig Latin,该语言的编译器会把类 SQL 的数据分析请求转换为一系列经过优化处理的 MapReduce 运算。
[Apache HBase](http://hbase.apache.org/): 是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用 HBase 技术可在廉价 PC Server 上搭建起大规模结构化存储集群。
[Apache Sqoop](http://sqoop.apache.org/): 是一个用来将 Hadoop 和关系型数据库中的数据相互转移的工具,可以将一个关系型数据库(MySQL ,Oracle ,Postgres 等)中的数据导进到 Hadoop 的 HDFS 中,也可以将 HDFS 的数据导进到关系型数据库中。
[ZooKeeper](http://zookeeper.apache.org/): 是一个为分布式应用所设计的分布的、开源的协调服务,它主要是用来解决分布式应用中经常遇到的一些数据管理问题,简化分布式应用协调及其管理的难度,提供高性能的分布式服务
[Apache Mahout](http://mahout.apache.org/):是基于 Hadoop 的机器学习和数据挖掘的一个分布式框架。Mahout 用 MapReduce 实现了部分数据挖掘算法,解决了并行挖掘的问题。
[Apache Cassandra](http://cassandra.apache.org/):是一套开源分布式 NoSQL 数据库系统。它最初由 Facebook 开发,用于储存简单格式数据,集 Google BigTable 的数据模型与 Amazon Dynamo 的完全分布式的架构于一身
[Apache Avro](http://avro.apache.org/): 是一个数据序列化系统,设计用于支持数据密集型,大批量数据交换的应用。Avro 是新的数据序列化格式与传输工具,将逐步取代 Hadoop 原有的 IPC 机制。
[Apache Ambari](http://incubator.apache.org/ambari/): 是一种基于 Web 的工具,支持 Hadoop 集群的供应、管理和监控。
[Apache Chukwa](http://incubator.apache.org/chukwa/): 是一个开源的用于监控大型分布式系统的数据收集系统,它可以将各种各样类型的数据收集成适合 Hadoop 处理的文件保存在 HDFS 中供 Hadoop 进行各种 MapReduce 操作。
[Apache Hama](http://hama.apache.org/): 是一个基于 HDFS 的 BSP(Bulk Synchronous Parallel)并行计算框架, Hama 可用于包括图、矩阵和网络算法在内的大规模、大数据计算。
[Apache Flume](http://flume.apache.org/): 是一个分布的、可靠的、高可用的海量日志聚合的系统,可用于日志数据收集,日志数据处理,日志数据传输。
[Apache Giraph](http://giraph.apache.org/): 是一个可伸缩的分布式迭代图处理系统, 基于 Hadoop 平台,灵感来自 BSP (bulk synchronous parallel) 和 Google 的 Pregel。
[Apache Oozie](http://oozie.apache.org/): 是一个工作流引擎服务器, 用于管理和协调运行在 Hadoop 平台上(HDFS、Pig 和 MapReduce)的任务。
[Apache Crunch](http://incubator.apache.org/crunch/): 是基于 Google 的 FlumeJava 库编写的 Java 库,用于创建 MapReduce 程序。与 Hive,Pig 类似,Crunch 提供了用于实现如连接数据、执行聚合和排序记录等常见任务的模式库
[Apache Whirr](http://whirr.apache.org/): 是一套运行于云服务的类库(包括 Hadoop),可提供高度的互补性。Whirr 支持 Amazon EC2 和 Rackspace 的服务。
[Apache Bigtop](http://bigtop.apache.org/): 是一个对 Hadoop 及其周边生态进行打包,分发和测试的工具。
[Apache HCatalog](http://incubator.apache.org/hcatalog/): 是基于 Hadoop 的数据表和存储管理,实现中央的元数据和模式管理,跨越 Hadoop 和 RDBMS,利用 Pig 和 Hive 提供关系视图。
[Cloudera Hue](http://cloudera.github.io/hue/): 是一个基于 WEB 的监控和管理系统,实现对 HDFS,MapReduce/YARN, HBase, Hive, Pig 的 web 化操作和管理。
**参考资料:**